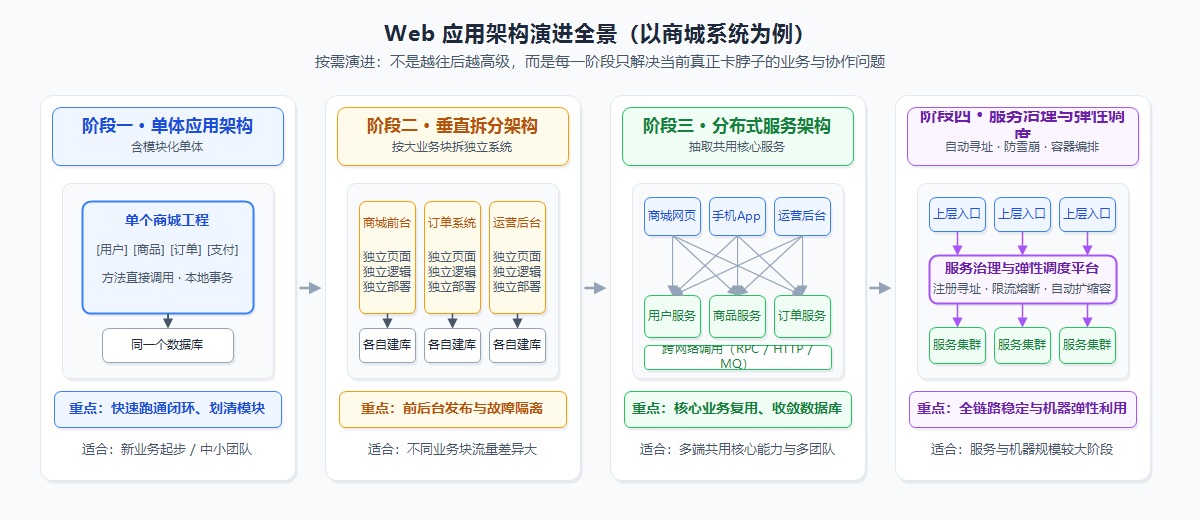
一个 Web 应用刚开始通常没有复杂的架构。页面、业务逻辑和数据访问放在同一个工程里,数据库也只有一套。
后来需要拆,一般不是因为单体“落后”,而是遇到了一些绕不开的问题:发一次版要回归整个系统,后台跑个大报表会把前台交易拖死,或者十几个研发改同一份代码天天冲突。架构变化解决的是这些具体问题。
一、单一应用架构
业务刚起步时,用户、商品、订单、支付都写在一个工程里,打成一个包部署,连同一个数据库。
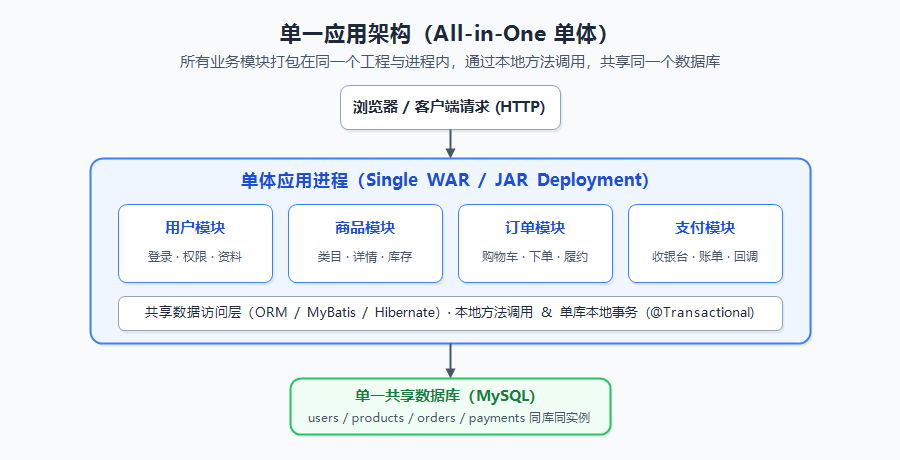
这种形态开发和排障都很直接。模块之间是进程内的普通方法调用,没有网络超时和序列化问题;下单和扣库存都在同一个库里,加一个本地事务就能保证同时成功或同时回滚;本机 IDE 能直接拉起整套系统,看日志也只盯一个进程。
等代码越写越多,先不用急着拆成多个服务。把工程内部的模块边界划清楚,規定订单模块只能调商品模块的接口、不能直接改商品表,再配合缓存和静态资源分离,足够撑过很长一段时间。
真正让单体撑不住的通常是三件事:多人共改一个工程导致编译和发布互相阻塞;边缘功能的慢 SQL 或内存溢出直接把核心交易拖挂;大促时明明只有下单接口压力大,却只能把整个大包一起复制扩容。
二、垂直应用架构
单体大到不好维护时,最顺手的拆法是按业务板块切分。比如把商城前台、订单系统、运营后台拆成三个独立的工程,各自单独打包部署,数据库也分开。
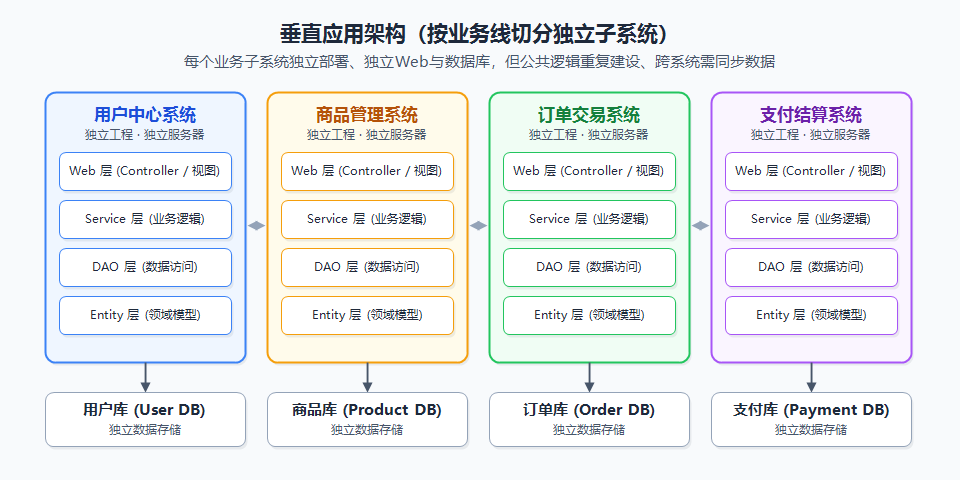
拆开之后,不同团队各管各的仓库,运营后台重启或卡死不会再影响前台用户买东西,哪个系统流量大就单独给哪个系统加机器。
但这种拆法假设业务之间互不相干,实际上很难做到。前台下单要算优惠、查库存,运营后台改单也要算优惠、查库存。两边各自写一套,规则一改就容易对不上。更麻烦的是数据,几个系统都要用用户和商品信息,没有统一的公共服务层时,只能靠定时任务互相同步表,或者跨系统直连别人的数据库,时间一长表结构谁也不敢动。
三、分布式服务架构
当不同系统之间重复的业务代码和数据同步越来越多,就会把用户、商品、订单、支付这些核心业务抽出来,做成独立的服务。上层的网页端、App 接口、运营后台只负责接收请求和组装页面,真正读写核心数据时,统一通过网络调用下层的服务。
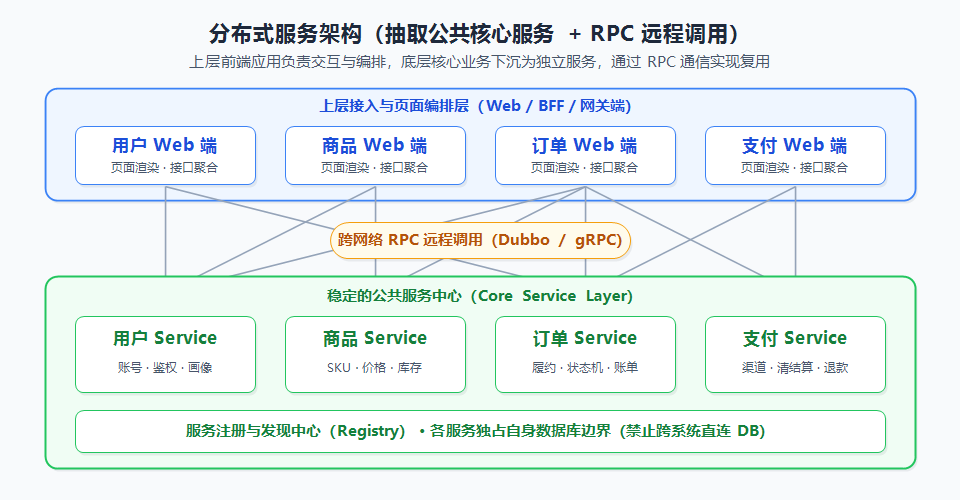
这样核心规则只维护一份,数据库边界也收干净了:谁的表谁负责读写,其他系统只能调接口,不能再跨库直连。
代价是原本稳妥的本地方法调用变成了跨网络调用。网络会抖动、会超时,订单服务调支付服务没拿到返回时,分不清是请求没发过去还是支付已经成功了,所以接口必须考虑重试和幂等。另外,订单和库存分到了两个服务、两个数据库里,没法再用一个本地事务捆在一起回滚,需要引入消息队列、定时重试或对账补偿来保证最终一致。服务也不能拆得太碎,否则前端点一下按钮,内部要串十几次网络调用,延迟高,报错时查日志也很痛苦。
四、服务治理与弹性调度
独立部署的服务只有几个时,人工记一下地址、出了问题登机器看日志还能应付。等服务变成几十个、机器上百台,调用关系和机器管理就会变成新的负担。
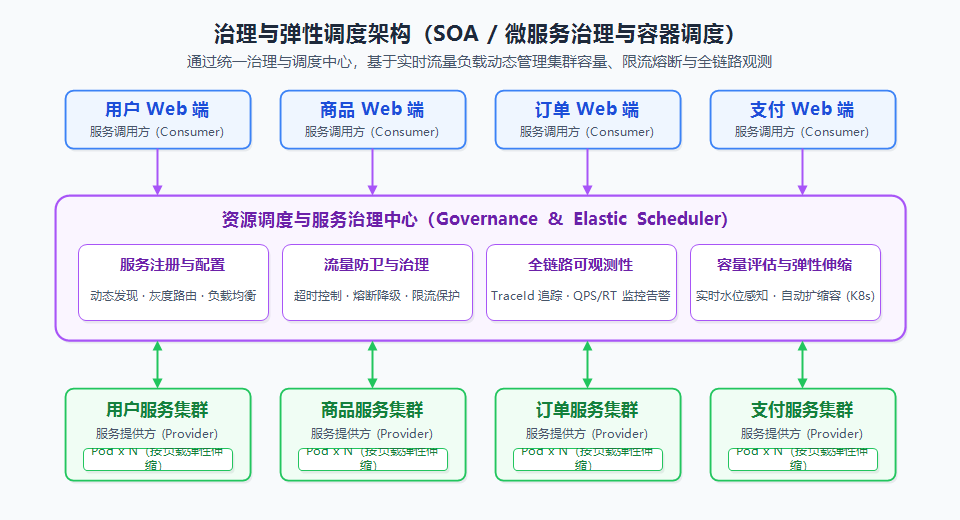
这时候就需要一套公共的治理和调度机制。服务启动后自动到注册中心登记地址,调用方按名字找节点,不用再手写 IP;某个下游服务变慢或挂掉时,能及时限流、熔断,避免把上游请求全部拖死;每次请求分配一个 TraceId 贯穿整条调用链,方便在十几个服务里把同一次请求的日志串起来;同时根据实时流量自动增减实例(例如用 Kubernetes 管理容器),高峰期扩容顶住压力,低峰期缩容省下机器。
回过头看,这几种形态并不是非走不可的升级台阶。每往后走一步,都是拿网络通信、数据一致性和运维成本,去换取业务拆分后的独立发布与扩展能力。能用简单结构解决的问题,就不要提前引入下一阶段的复杂度。